
AI工程:提示工程只给 66 屏,这个取舍比多数书清醒
微信读书《AI 工程:大模型应用开发实战》([越]奇普·萱 Chip Huyen 著,中文版)· 逐页翻阅 827 屏 · 抓取标记 reached_end=True(end_reason=last_page,书尾落在"封面简介")· 阅读器共记录 63 个章块,十章 · 抓取耗时 2144.3 秒。
抽样说明:我按"章节厚度 + 是否给出可核对的数字"抽读——p0004 英文版赞誉、p0006 中文版赞誉、p0050 第 1 章 AI 工程的兴起与标普 500 曲线、p0230 第 3 章困惑度公式、p0265 AI 当裁判的收尾、p0290 第 4 章评估维度、p0350 评估流水线第 2 步、p0400 提示词工具的成本账、p0545 第 7 章显存与量化。
章屏数按阅读器章标签逐页归属计算,含章标题页。所有引文与数字只来自上述页面;"取舍比多数书清醒""例子几乎都长在美国"是我的判断,不是书里的自评。
先说结论:这本书最值钱的地方,是它没有把提示词当成核心。
市面上讲大模型应用的书,十本里有八本把"提示词工程"放在第一章,剩下两本放在第二章。这本书把它排到了第 5 章,而且只给了 66 屏——全书最薄的一章。相反,它给了"评估"两章 158 屏,"理解基础模型"一章 101 屏。
这个排序不是排版失误,是立场。它的意思是:你能不能把应用做好,取决于你能不能判断输出好坏,而不是取决于你会不会写"你是一位资深律师"。这个判断我认同,而且我认为它比书里任何一句具体建议都值钱。
但我也得说清楚它的问题:这套方法论长在别人的语料、别人的合规环境、别人的基准测试上。826 屏读完,我数不出三个中文场景的例子。
一、先看它的取舍:提示工程被排到第 5 章,只有 66 屏
十章的结构是这样的:第 1 章"基于基础模型构建 AI 应用入门"80 屏;第 2 章"理解基础模型"101 屏;第 3 章"评估方法论"74 屏;第 4 章"评估 AI 系统"84 屏;第 5 章"提示工程"66 屏;第 6 章"RAG 与智能体"88 屏;第 7 章"微调"90 屏;第 8 章"数据集工程"67 屏;第 9 章"推理优化"71 屏;第 10 章"AI 工程架构与用户反馈"69 屏。前置(版权、中英文赞誉、译者序、中文版序、前言)37 屏。
把前三块加起来:原理 101 屏、评估 158 屏、提示工程 66 屏。评估是提示工程的 2.4 倍。
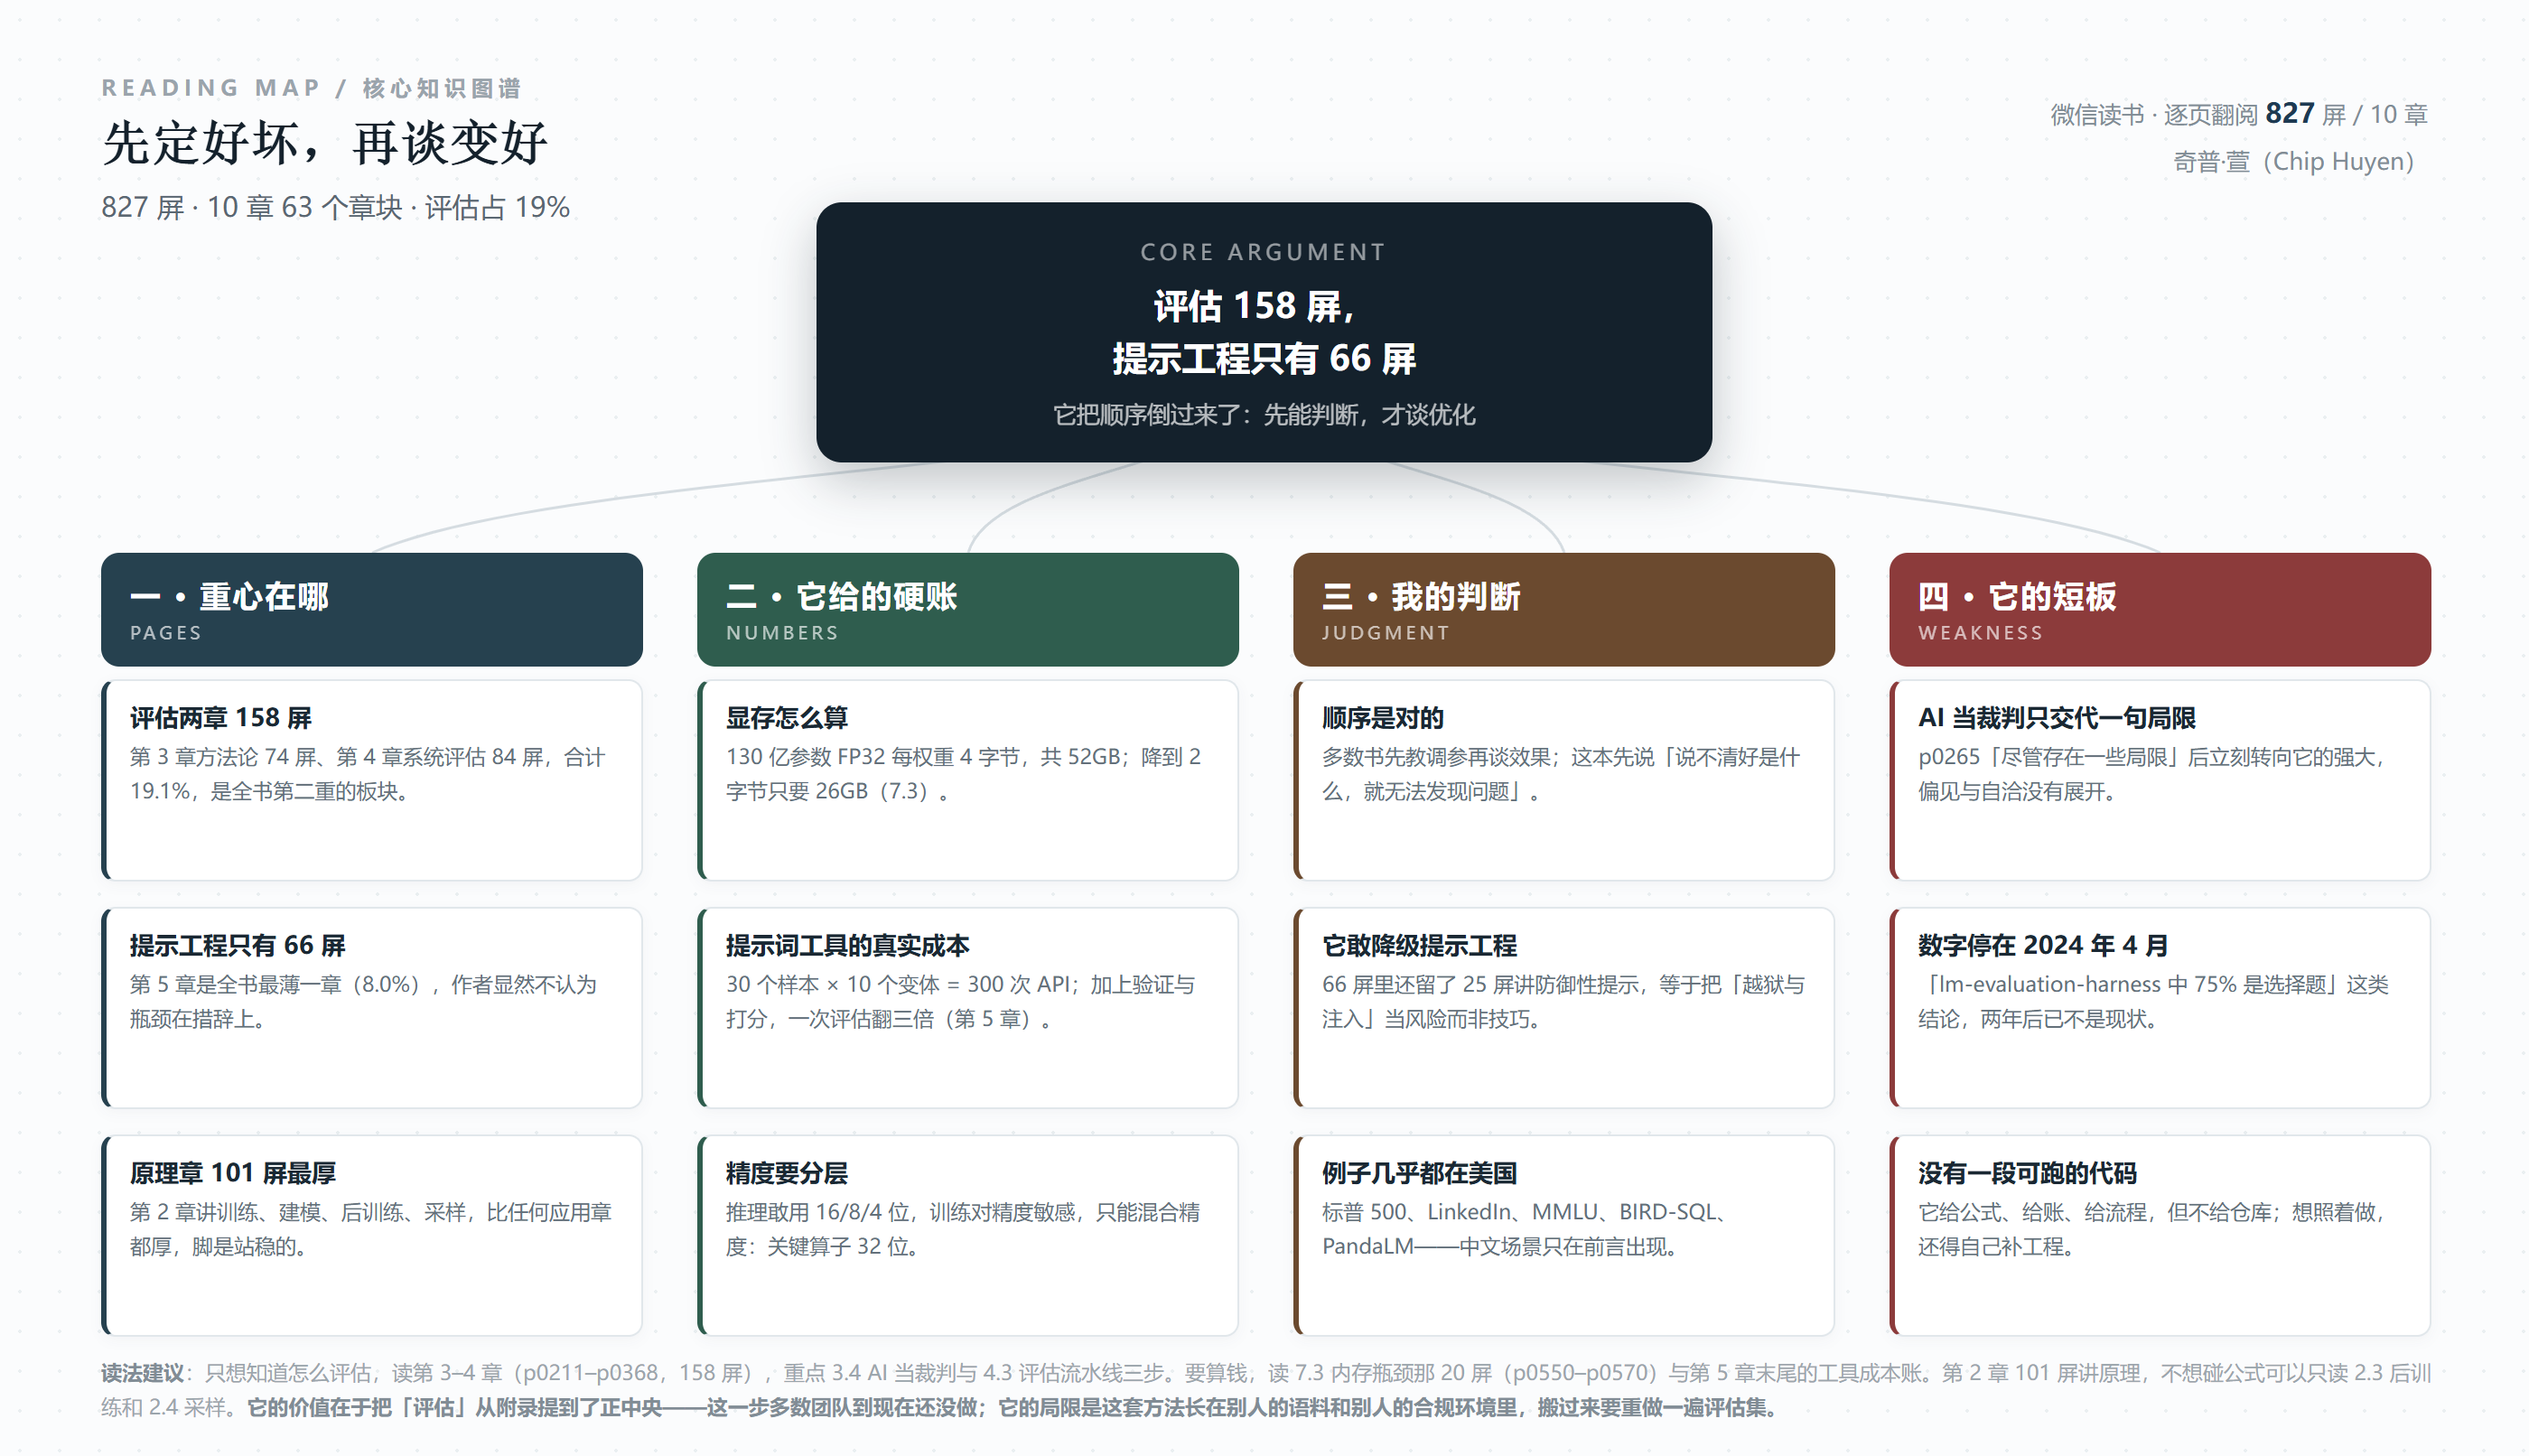
更有意思的是第 5 章内部的分配。66 屏里,5.1 提示词简介和 5.2 最佳实践占了大半,5.3"防御性提示工程"占了 25 屏——将近四成。也就是说,这一章真正花力气的地方不是"怎么让模型答得更好",而是"怎么防止别人让你的模型答出不该答的东西"。
这是一个很成熟的态度。提示词技巧是可以互相抄的,越狱和注入是必须自己防的。作者把篇幅放在后者,说明她知道读者真正会翻车的地方在哪。
顺带说一句,这本书的编辑也做过取舍:827 屏里,第 2 章"理解基础模型"是唯一一章讲训练的——训练数据、建模、后训练、采样,四个小节,101 屏,是全书最厚的一章。一本讲"应用开发"的书,把最多的篇幅给了"模型是怎么来的",这在同类书里少见。它的好处是你后来读微调、读量化、读推理优化时,脚底下有东西;坏处是如果你只想周五之前做出一个 demo,前 200 屏会很煎熬。
二、827 屏的重心:它把"评估"提到了正中央
第 3 章开头有一段话,我认为是全书的方法论基石,值得完整抄下来:
创建清晰的评估指南是评估流水线中最关键的一步。模糊的指南会导致评分含混不清,甚至产生误导。如果你不知道什么样的响应是"坏"的,你就无法发现问题所在。(p0350)
紧接着的一句更狠:"通常,评估过程中最困难的部分并不是判断输出结果的好坏,而是明确'好'的定义。"
这两句话把大多数团队的现状说穿了。我们习惯的动作是:先做一个 demo,看着挺像,上线,然后靠用户投诉来发现问题。而这本书的顺序是:先把"好"写成可判定的标准,再谈模型选型、提示词、微调。它甚至举了 LinkedIn 的例子——"LinkedIn 在回顾部署生成式 AI 应用一年的经验时指出,他们遇到的第一个障碍就是制定……"(这一句被页脚截断,但意思很明确:第一个障碍是定义标准,不是技术)。
它在同一节里还提醒了一件容易被忽略的事:评估指南不仅要说"应该做什么",还要说"不应该做什么"。原书的例子是客服机器人——它是否应该回答与产品无关的问题,比如即将到来的选举?如果答案是不应该,那你必须定义:哪些输入算超出范围,怎么识别这些输入,应用该怎么回应。这三件事不写清楚,"不回答无关问题"就只是一句口号。
第 4 章把这件事往下推了一层:功能正确性不是唯一维度。书里用了一个我很喜欢的类比——"你会想要一辆能跑但耗油量过大的汽车吗?"同理,一个文本转 SQL 的模型,生成的查询语法正确,但跑十分钟、吃满内存,那它不能投入实际使用。为此它引了 BIRD-SQL 这个基准(Li 等,2023),特点是除了执行准确性,还比较生成查询与标准查询的运行时间。
再往下是"可读性"这个维度。书里说得很实在:如果生成的代码能运行但没人看得懂,后续维护和系统集成会非常困难;而可读性缺乏精确评估方法,只能靠主观评估,比如用 AI 裁判。这一段的价值在于它承认了"有些东西量不出来",然后给了一个次优解,而不是假装什么都能算。
这三层——先定义好坏、再拆多维度、最后承认哪些维度只能主观判——构成了这本书评估观的全貌。我认为它比"评估很重要"这种正确的废话高一个段位,因为它给了操作顺序。
再补一层它没写在标题里的区分:封闭式任务与开放式任务。书里的说法是,非编程领域的能力通常使用封闭式任务来评估,例如选择题——"如果想评估模型的数学能力,一种开放式方法是让模型生成给定问题的解答;而封闭式方法则是给模型几个选项,让它选择正确答案。如果正确答案是选项 C,而模型输出了选项 A,那么模型的响应就是错误的。"
这个区分看着像学术细节,实际决定了你的评估能不能自动化。封闭式任务可以机器判分,几百条样本跑一夜就出结果;开放式任务必须人看,或者用 AI 裁判去近似人看。所以当一个团队说"我们做了评估"时,第一句该问的是:你评的是选择题还是作文?如果是作文,谁在打分?这两个问题的答案,决定了那份评估报告值不值得信。
书里还给了评估任务的另一个思路,我很喜欢,因为它把"考模型"变成了"设计一个好游戏"。4.3 之前那一节介绍的是"20 个问题":模型的一方(Alice)选一个概念,比如苹果、汽车或计算机;另一方(Bob)通过一系列问题去确定这个概念,Alice 只能回答"是"或"否";评分取决于 Bob 是否猜出概念,以及用掉了多少个问题。书里引了 BIG-bench 仓库里的一段真实对话:
Bob: Is the concept an animal? Alice: No.
Bob: Is the concept a plant? Alice: Yes.
Bob: Does it grow in the ocean? Alice: No.
Bob: Does it grow in a tree? Alice: Yes.
Bob: Is it an apple? [Bob's guess is correct, and the task is completed.](p0350)
这个设计的妙处在于:它同时评了两件事——猜得对不对,和问得省不省。只评对错,模型可以瞎问二十轮;只评效率,模型可以乱猜。两个指标绑在一起,才逼出"有策略地提问"这个能力。你给自己的业务造评估集时,这个结构可以直接借:任何一个"多轮对话"场景,都该同时记"最终对不对"和"花了几轮"。
三、三笔可以直接抄走的账
这本书给公式,也给账。三笔账我抄下来了。
第一笔:显存账。7.3 节讲微调的内存瓶颈,先给结论:"可训练参数量越多,内存占用越多。你可以通过减少可训练参数量来降低微调的内存需求,这正是 PEFT 的设计初衷。"然后给了一个可以当场算的例子:
以一个拥有 130 亿个参数的模型为例,使用 FP32 意味着每个权重需要 4 字节,总共需要 52 GB 内存。如果能将每个数值减少到仅需 2 字节,那么所需的内存将降至 26 GB。(p0545)
这笔账的意义不在于 52 和 26 这两个数,而在于它把"我要不要微调"从感觉变成了乘法。130 亿参数 × 4 字节 = 52GB,这是权重本身;再加上梯度和优化器状态,实际需求是数倍。算完你就知道自己的卡够不够,而不是先租机器再说。同页还给了一条判据:推理通常用尽可能低的位宽(16 位、8 位甚至 4 位),训练对数值精度更敏感,所以只能用混合精度——部分算子 32 位,部分 16 或 8 位。这句话解释了为什么"量化后的模型能跑推理但不能拿来微调"。
第二笔:提示词工具的成本账。这是第 5 章末尾我没想到会看到的内容。书里说,提示工程工具通常会发起隐性的模型 API 调用,不加控制会迅速耗尽配额:
假设每个变体需要调用一次 API,如果有 30 个评估样本和 10 个提示词变体,就意味着需要调用 300 次 API。(p0400)
然后它补了一刀:每段提示词通常还不止一次调用——一次生成响应,一次验证响应(比如验证返回的是不是有效 JSON),一次给结果打分。300 次乘以 3,900 次。这个数字很有说服力:很多人以为自己在"调提示词",其实是在跑一个小规模的模型评测,成本结构完全不同。
同页还有一个细节让我对这本书的严谨度加分:它指出提示词模板本身可能带错。图 5-9 展示的 LangChain 默认提示词里,有一句拼写错误——"Let'w work this out in a step by step way","Let's" 被打成了 "Let'w"。这种错误不影响运行,但会悄悄影响输出质量,而且几乎没人会去读框架源码里的模板字符串。作者把它写进书里,说明她真的读过。
第三笔:选择题的比例。第 4 章讲封闭式任务评估时说,"截至 2024 年 4 月,Eleuther 的 lm-evaluation-harness 中 75% 的任务是选择题",包括 MMLU 这类基准。这个数字解释了一个长期困惑:为什么模型在榜单上分数很高,实际用起来却不行——因为大部分公开基准测的是"从选项里挑一个",而真实场景要求"从零写一个"。
三笔账的共同点是:都能当场算,都不需要 GPU,都能改变一个决策。这种内容在中文 AI 书里是稀缺品。
顺带说一笔它教了公式、但你多半算不出来的账:困惑度。第 3 章给了完整定义——给定语言模型和 token 序列,困惑度是模型预测该序列难度的度量,公式是各 token 条件概率连乘后开 n 次方、再取倒数。理论上,困惑度可以横向比较不同模型对同一段文本的"惊讶程度",是选基座时最便宜的一个指标。但书里紧接着写了一句话,把这条路堵了一半:
要计算困惑度,你需要获得语言模型对每一个后续 token 分配的概率(或对数概率)。遗憾的是,并非所有商业模型都会公开其对数概率。(p0230)
这正是这本书的风格:给公式,也给公式的失效条件。很多书写到公式就停了,读者拿去一用发现调不通,然后怀疑自己。提前告诉你"这条路走不通",比多给你三个技巧更有用。这一句我给它记了一功。
四、AI 当裁判:全书最诚实的一节,也是最容易被误用的一节
3.4 节讲"AI 当裁判"。这一节的态度我很欣赏:它不吹,也不否定。
书里先给了图 3-9:两个模型(Bloom 和 Llama)对同一段话给出解释,裁判模型 PandaLM 输出判断——"Response 2 is better because it provides a clear and concise explanation of the meaning of the phrase",并附上参考答案。图注标明图片来自 Wang 等(2023),为可读性做了修改,遵循 Apache License 2.0。这种标注方式很规范,能看出是认真做的书。
然后是本节的收尾,我原样抄下来:
尽管存在一些局限,AI 当裁判的方法仍然非常灵活且强大。使用成本更低的模型作为裁判,使得这种方法更加实用。我身边许多最初持怀疑态度的同事,现在也开始在生产环境中越来越多地依赖这种方法。(p0265)
这段话诚实,也暴露了这本书的一个态度:它是从业者写的,不是审稿人写的。"我身边许多最初持怀疑态度的同事"这种第一人称,在拼凑型的书里看不到。
但我必须在这里提出批评。这一节把"局限"压缩成了四个字——"存在一些局限",然后立刻转向它的强大和实用。而 AI 当裁判的局限至少有四条,且每一条都会直接毁掉评估结论:
一是位置偏见。裁判模型倾向于偏好它先看到的那个答案,所以同一组回答,交换顺序后会得到不同结论。二是长度偏见。更长的回答通常得分更高,哪怕内容更空。三是自我偏好。用 GPT 系模型评 GPT 系的输出,分数会系统性偏高。四是没有校准。裁判给的是排序,不是绝对分,你没法知道"这个回答 8 分"意味着什么。
这四条在学术文献里都有对应研究,而书里只用一句话带过。对一个把评估放在正中央的方法论来说,这是全书最不该轻描淡写的地方——因为读者一旦照着做,很容易得到一个"看起来很科学"的排行榜,然后拿它做决策,而这套排行榜的偏差是系统性的、不可见的。
我给一个补法:任何 AI 裁判的结果,都要用 30 到 50 条人工标注做一次对齐。先让裁判排序,再让人排序,看两者的相关系数;如果低于 0.7,这套裁判就不能用于上线决策。这个动作成本不到一天,但能把"我用了 AI 评估"从心理安慰变成工程证据。书里没给这一步,这是它方法论上最大的缺口。
五、它的例子几乎都长在美国
827 屏读下来,我记下的具体案例和基准是这样的:标普 500 公司在财报电话会议里提及 AI 的数量(p0050,图 1-5,2023 年冲到 177 次的历史新高,数据来源 FactSet);LinkedIn 部署生成式 AI 一年的复盘;MMLU 与 Eleuther 的 lm-evaluation-harness;BIRD-SQL 的文本转 SQL 基准;PandaLM 的裁判示例;BIG-bench 的 20 个问题游戏;宝洁、玛氏、OpenAI、谷歌的推荐语。
这些例子都很好,问题是它们回答的是"美国的团队在美国的合规环境下怎么做事"。
中文场景我找到的只有前言里的提及,正文十章没有一个中国企业的部署案例,没有一次中文语料的评估集构造示例,也没有一段关于数据出境、内容安全审核、生成内容标识的讨论。对一个中文读者来说,这意味着两件事:
第一,方法可以搬,案例不能搬。评估流水线的三步、显存账、AI 裁判的对齐方法,这些是通用的;但"你的评估集从哪来"这个问题,只能自己解决——公开中文基准未必覆盖你的业务,客户对话里的真实样本又涉及合规。
第二,有些维度这本书整本都没提,但它们在国内是硬约束。比如模型输出必须可追溯、必须能被内容安全策略拦截、必须在特定类目下拒答。这些不是"评估的一个维度",是"能不能上线的前置条件"。书里的评估框架装得下它们,但作者没有帮你放进去。
我不认为这是作者的失误——她写的是自己熟悉的工程环境,而且写得很扎实。但作为中文版的读者,这件事必须自己补上,否则你会得到一套漂亮的、无法落地的评估表。
六、它的短板
集中说四条。
第一,AI 当裁判的局限被压缩成一句话。如上所述,位置偏见、长度偏见、自我偏好、缺乏校准这四条,每一条都会系统性污染评估结果,而书里只有"尽管存在一些局限"。对一个把评估当核心方法论的书来说,这是结构性缺口,不是小瑕疵。
第二,数字停留在 2024 年 4 月。"lm-evaluation-harness 中 75% 是选择题"这句话,在写作时是准确的,两年后未必。这不怪作者,但读者要注意:这本书的结论是"某时某地的方法",不是"永远成立的定律"。它自己也在多处标注了时间点,这是一种诚实,但也提醒你别把里面的数字当现状。
第三,全书没有一段可运行的代码。我抽读的九页里有公式(困惑度那一页的连乘式)、有账、有流程图、有框架截图,但没有一段能直接跑的代码,也没有配套仓库。它不是代码书,这没错;但第 6 章"RAG 与智能体"88 屏、第 7 章"微调"90 屏,这两块恰恰是最需要代码的,纯讲方法会让人读完仍不知道从哪个文件开始改。
第四,第 1 章的乐观有点过头。p0050 有一句话:"现在,任何人——我是说任何人——都可以开发 AI 应用。"这句话在"能做出 demo"的意义上成立,在"能做出可靠系统"的意义上不成立——而这本书后面 700 多页恰恰在证明后一件事有多难。开篇的这句口号和全书的严谨气质是矛盾的,像是为了卖书加的一句。
公平地说,这本书的强项也很明确:它敢把评估放在提示工程前面;它给的是能算的账不是形容词;它承认有些东西量不出来;它连 LangChain 模板里的拼写错误都写进书里。四点加起来,它在同类书里属于上乘。
七、它没教的一件事:评估集从哪来
这一节是我自己的补充,不是书里的内容,先说清楚。
这本书把"定义好坏"讲透了,把"用 AI 裁判"讲透了,但在我抽读的页面里,没有看到"第一批评估样本从哪来"的讨论。而这恰恰是所有人卡住的地方——标准能写,裁判能调,样本没有。
三条路,按性价比排。
第一条,从业务日志里回捞。如果你的应用已经上线,最真实的一批样本就在历史对话里。捞两百条,人工标一遍,这就是你的第一个评估集,而且它天然带着你业务的分布——客户真正会怎么问、会在哪一步卡住、会因为什么骂人。缺点是脏,需要清洗和脱敏。这条路见效最快,可惜只有已经上线的团队走得了。
第二条,用公开基准做能力体检。MMLU、BIRD-SQL 这类基准的价值不在"预测你的业务效果",而在"排除明显的选型错误"。花半天跑一轮,你能知道某个候选基座在数学、代码、多语言上是不是瘸腿的。但千万别拿基准分数直接决定上线——书里那句话已经解释过原因:大部分公开基准测的是选择题,而你的业务是作文。
第三条,合成样本。用强模型按你的业务场景生成问题,再人工筛。这条路能快速把评估集从 50 条扩到 500 条,代价是分布会向"模型觉得像的问题"偏移,越用越自洽、越用越测不出真问题。我的经验是合成样本不超过评估集的三分之一,且必须留一批纯人工写的"脏样本"做锚点。
三条路合起来,一个下午能做出 200 条带标注的评估集。这件事没有技术含量,但它决定了后面所有方法能不能用。书里给了菜谱,没给买菜的地方——这不算它的错,因为买菜这件事只能在你自己家门口做。
八、怎么读
如果你的目标是"把手上这个应用做稳":直接读第 3 章和第 4 章,158 屏(p0211–p0368)。重点两处——3.4 的 AI 当裁判(但要配我上面说的 30 到 50 条人工对齐),4.3 的评估流水线三步(定义标准、创建指南、选模型)。这两章读完,你至少知道该问自己什么问题。
如果你的目标是"省钱":读 7.3 内存瓶颈那 20 屏(约 p0550–p0570),把 130 亿参数那笔账自己代入一遍;再读第 5 章末尾的工具成本账,算清楚你调一次提示词到底花了多少次调用。
如果你的目标是"补原理":第 2 章 101 屏(p0110–p0210),不想碰公式的可以只读 2.3 后训练和 2.4 采样——这两节解释了一件事:为什么同一个基座,经过不同的后训练会变成性格完全不同的产品。
第 1 章 80 屏可以快读,它主要在论证"AI 很重要"这件事;第 10 章 69 屏讲架构与用户反馈,值得细读,因为它是全书唯一讲"上线之后怎么办"的部分。
最后提醒一句读法上的事:这本书的章节是按"工程流水线"排的,不是按难度排的。第 2 章最硬,第 5 章最软,跳过第 2 章直接读第 5 章不会看不懂,但你会在第 7 章卡住。
一句话:它把"评估"从附录搬到了正中央,这是这本书最值钱的判断;但它对 AI 裁判的偏见只交代了四个字,而整套方法论恰好架在这个有偏见的裁判身上。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: