
多模态数据分析:为什么讲 AGI 的那一章,比统计学还薄?
微信读书《多模态数据分析:AGI 时代的数据分析方法与实践》(巴川等)· 本次逐页翻阅 442 屏,从版权信息读到第 12 章小结,12 章 114 节全部覆盖,抓取标记为全书读完(end=last_page),耗时 347 秒。
说明:这是一本标着「AGI 时代」的技术书,我这次只问一个问题:它把篇幅给了什么,又把什么东西只是写在了封面上。
442 屏,12 章,114 个小节。平均每章 37 屏。
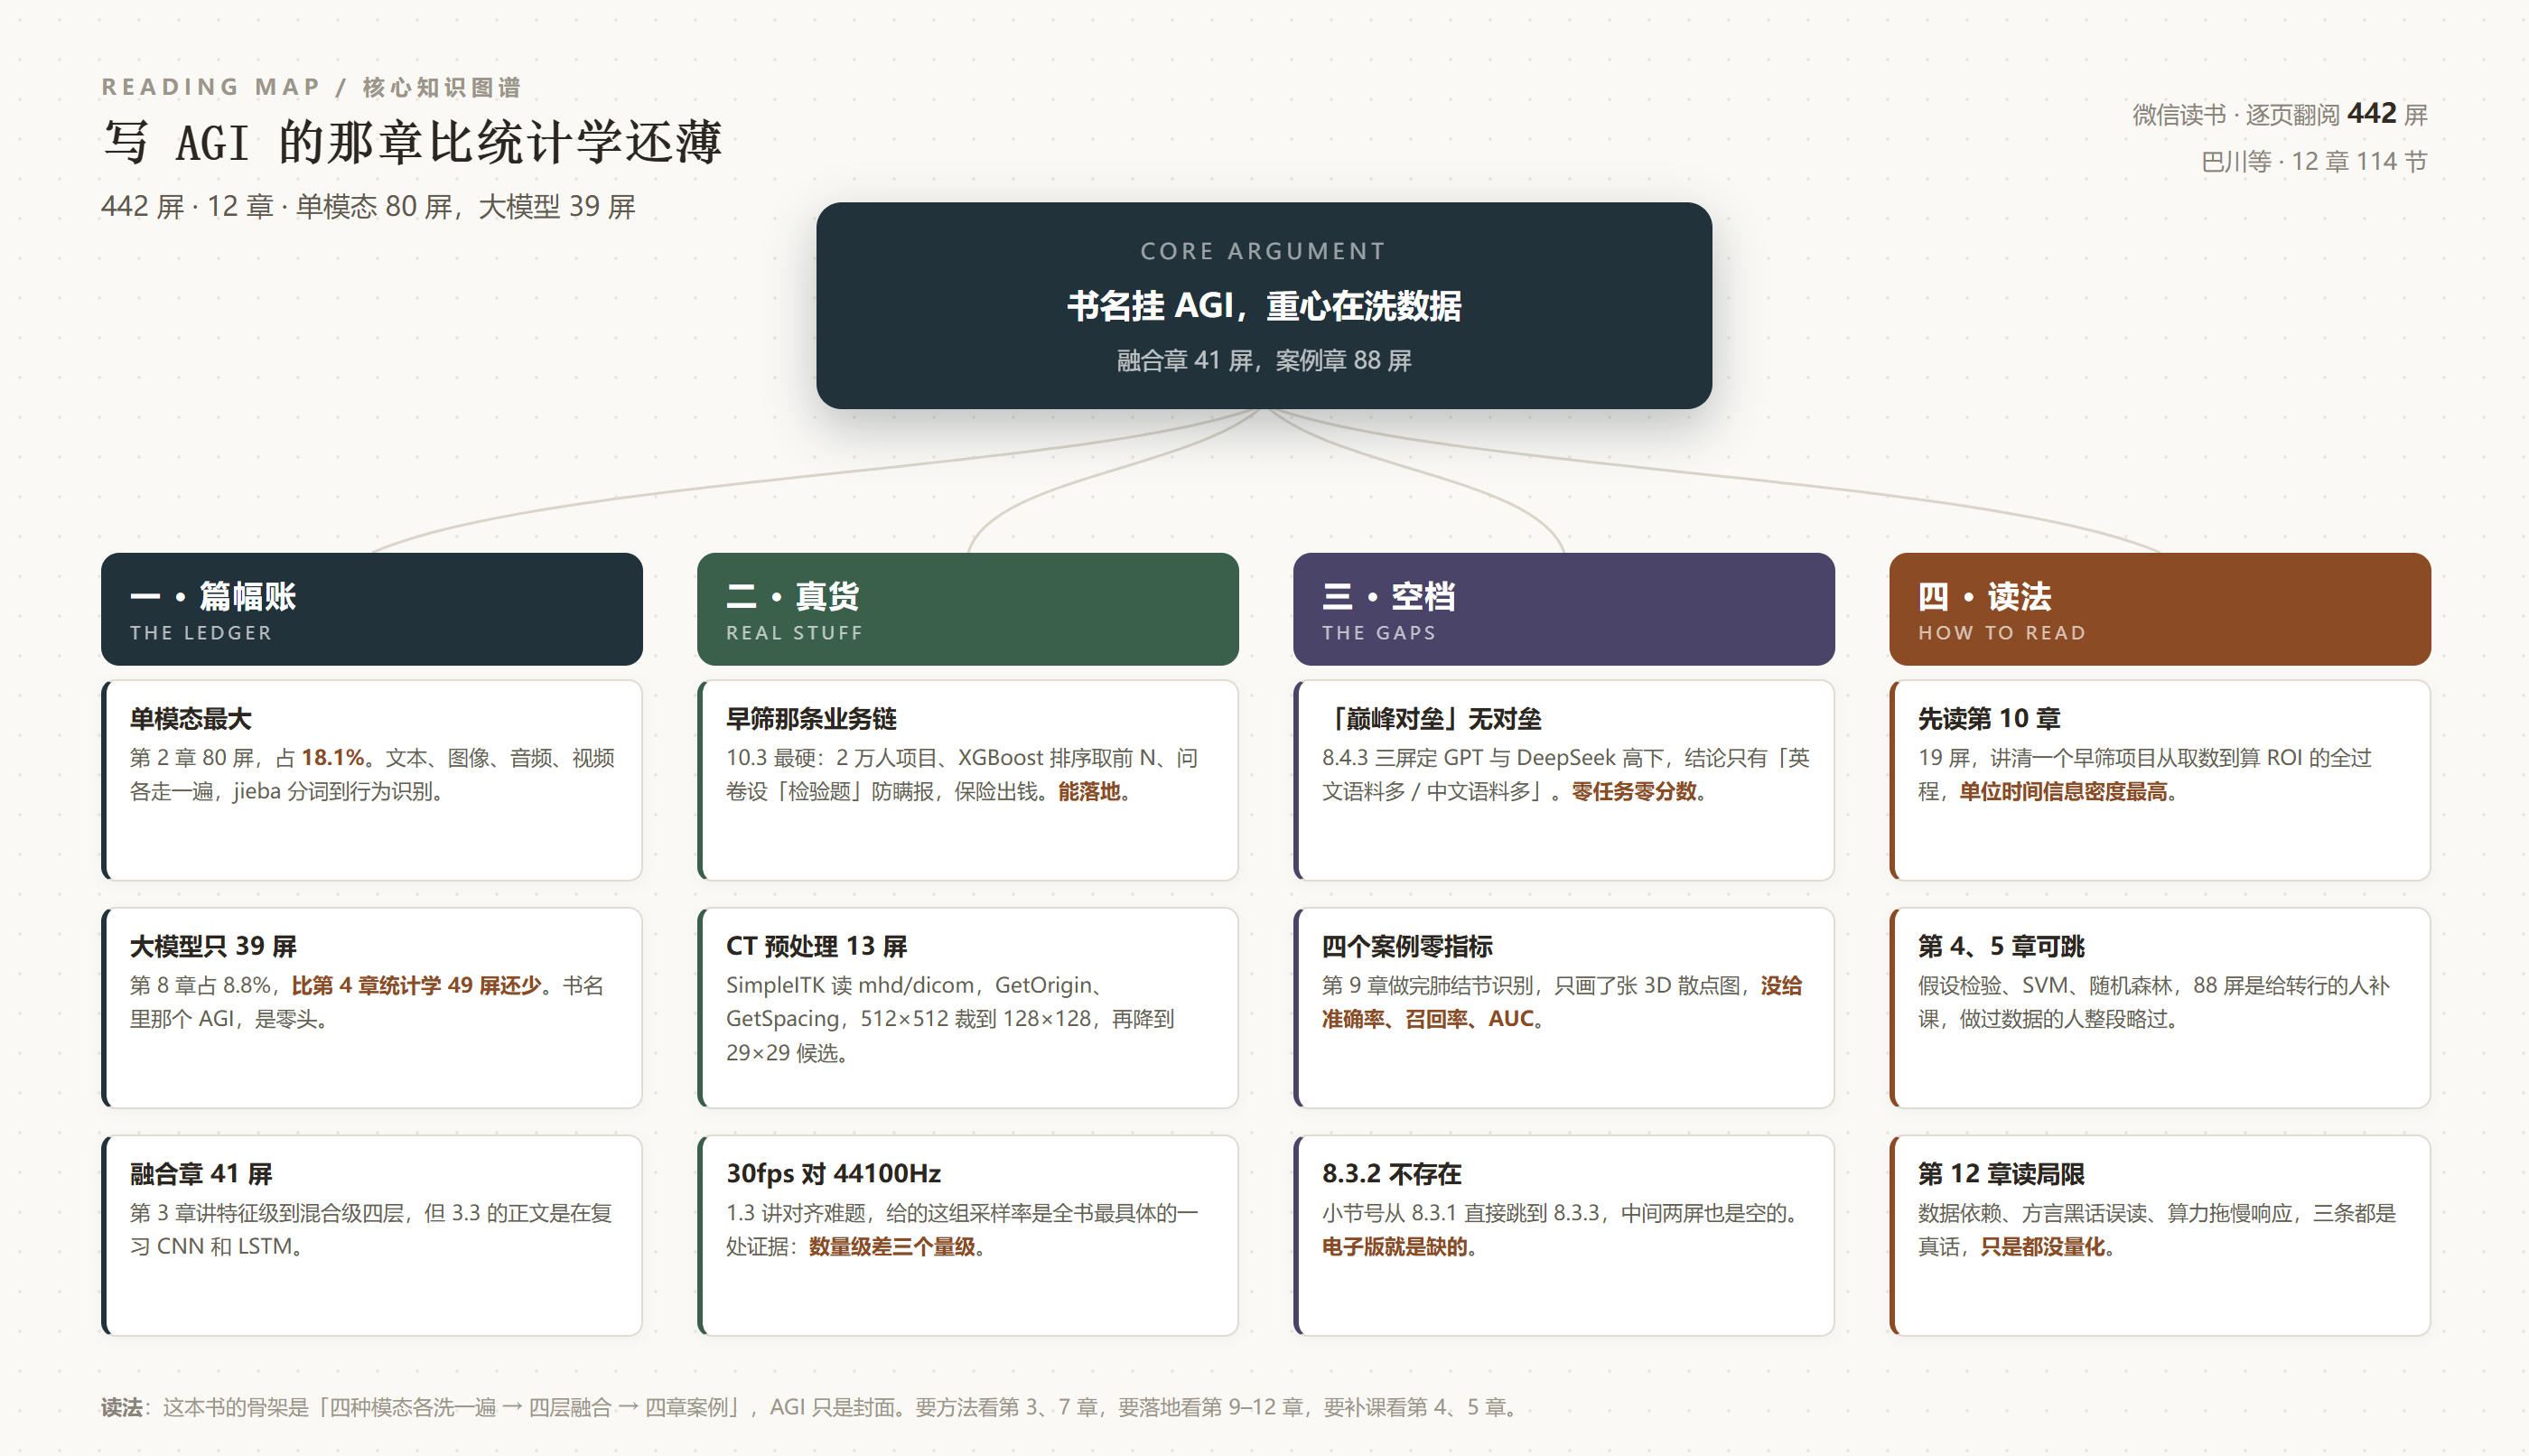
先给结论:这本书真正干活的地方,不是 AGI,是「把四种模态各自洗干净」。
把 442 屏摊开数一遍:第 2 章「单一模态数据处理与分析」80 屏,占 18.1%,是全书最厚的一章;第 8 章「基于大模型的多模态数据分析」39 屏,占 8.8%。用「AGI」当书名的这本书,讲大模型的那一章,比讲统计学的那一章还少 10 屏。统计学 49 屏,占 11.1%。
这个结构不是编排失误,是一种判断。它等于在说:做多模态分析,卡住你的不是模型不够大,是文本没分好词、CT 没对齐层厚、视频帧和音频采样率差三个数量级。这个判断我认同,而且认为它比那些一上来就讲 Transformer 的书诚实得多。但它也带来一个副作用——你在书店看到「AGI 时代」,翻开却发现前 148 屏在讲 jieba 分词和二手车回归,会觉得被书名骗了一次。
一、442 屏的账:单模态 80,融合 41,大模型 39
逐章统计,屏数如下。
第 1 章「多模态数据分析概述」13 屏,占 2.9%;第 2 章「单一模态数据处理与分析」80 屏,占 18.1%;第 3 章「多模态数据融合」41 屏,占 9.3%;第 4 章「统计学与数据分析」49 屏,占 11.1%;第 5 章「基于机器学习的多模态数据分析」39 屏,占 8.8%;第 6 章「基于深度学习的多模态数据分析」37 屏,占 8.4%;第 7 章「基于知识图谱的多模态数据分析」42 屏,占 9.5%;第 8 章「基于大模型的多模态数据分析」39 屏,占 8.8%;第 9 章「实战案例:挖掘肺部病变」29 屏,占 6.6%;第 10 章「实战案例:剖析疾病数据」19 屏,占 4.3%;第 11 章「实战案例:聚焦直播高光时刻」20 屏,占 4.5%;第 12 章「实战案例:解析优质视频」20 屏,占 4.5%。
十二章合计 428 屏,加文前 14 屏(版权、作者简介、内容简介、推荐语、前言),合计 442 屏,数对得上。
这个分布里,有三处值得说。
第一处:四个「实战案例」加起来只有 88 屏,占 19.9%,平均每章 22 屏。而四章里最薄的第 10 章只有 19 屏,最厚的第 9 章 29 屏。一本把「实践」写进副标题的书,实战部分不到五分之一,这个比例本身不算低;但四章里有三章(第 9、11、12 章)连小结都没写,第 9 章末尾那句「本章的案例中基于卷积神经网络模型,建立了一套肺结节辅助诊断筛查机制和算法」,就是全部收尾。
第二处:第 2 章 80 屏,是第 3 章融合的将近两倍。这本书叫「多模态」,可讲「怎么把多个模态合起来」的只有 41 屏,讲「每个模态各自怎么处理」的给了 80 屏。80 屏里,文本 18 屏、图像 19 屏、音频 13 屏、视频 23 屏,每种模态都是「预处理 + 一个任务」的两段式(文本分类与主题建模、图像目标检测、音频分类与事件检测、行为识别与动作分析)。书名里的「多模态」,在篇幅上是被「单模态」压着的。
第三处:第 4 章统计学 49 屏,比第 8 章大模型 39 屏多。49 屏里讲了描述统计、假设检验、相关性分析、回归分析,配一个「二手车怎么买」的案例和一套短语词云算法。这些内容在 2015 年的数据分析教材里一模一样。它出现在一本 2025 年出版、副标题写「AGI 时代」的书里,说明作者对读者的假设是:你可能连 p 值是什么都不知道。
这三处放在一起,这本书的定位就清楚了:它不是一本讲「AGI 怎么改变分析」的前沿书,是一本「从零到能跑通一个多模态项目」的教材。教材这个定位没问题,问题在封面。
还有一处比例值得一提:第 7 章「基于知识图谱的多模态数据分析」42 屏,比第 8 章大模型还多 3 屏。这一章里塞了四组内容:知识图谱技术体系加一个建图案例、多模态知识图谱做多标签预测、图神经网络做电影推荐、以及用户行为分析(传播路径、搜索、关系网络健康度)。前三组是标准教程内容,第四组才是作者自己的东西——他把自己做过的产品数据搬进来了。
这个安排透露了一件事:作者真正熟悉的是「用图谱把用户行为串起来」这套活,不是「用大模型做多模态推理」。所以他能把知识图谱写出 42 屏,把大模型写出 39 屏还夹着三屏空对垒。书的形状,是作者经验的形状。
二、它最实的一处证据,是 30fps 对 44100Hz
第 1 章 1.3 节「多模态数据分析的挑战」,全书 442 屏里,这一节给了一组我最认的数字。
它说视频与音频融合时,两者的时间分辨率不同:一段视频的帧率是每秒 30 帧,而音频的采样频率为 44100Hz,这意味着在同一时间段内,音频数据的采样点数量远远多于视频帧的数量。要实现有效融合,就得找到一种合适的方法,把音频采样点与对应的视频帧精确对齐。
这组数字为什么值钱?因为它把「多模态难」这个抽象说法,变成了一个能算的比值:一秒钟内,44100 个音频采样点对应 30 帧画面,1470 比 1。任何做过音视频对齐的人看到这个数,立刻就明白为什么要做重采样、为什么要按帧长切窗、为什么唇形同步那么难做。
同一节还讲了两层难:一层是特征空间的差异,文本是离散的词向量表示,图像是连续的像素矩阵,怎么把它们统一到一个融合空间,是「当前研究的难点」;另一层是语义层面的错配,做多模态情感分析时,要把文本里的情感倾向(积极、消极、中性)和图像里的面部表情(微笑、皱眉、愤怒)合起来判断,但两者经常不一致——嘴上说没事,脸是绷着的。
这是全书方法论最扎实的一节。它不吹 AGI,只告诉你对齐有多难,而且难在哪一层。
三、第 2 章那 80 屏,是真功夫也是真枯燥
第 2 章是全书最厚的一章,也是最能看出作者成色的一章。它的写法很统一:先讲原理,再贴代码,再贴运行结果。
文本那一节,用的是 jieba 分词加 scikit-learn。代码里先 jieba.lcut 把「他喜欢吃香蕉」「她喜欢吃橘子」这类句子切开,再用 CountVectorizer 和 TfidfVectorizer 转成词袋矩阵,最后打印出特征名和矩阵。印刷出来的运行结果是一张 4×4 的表,特征名是『喜欢』『橘子』『苹果』『讨厌』『香蕉』,每一行是 0 和 1。这段代码没有一句废话,也没有一句多余的解释,你照着敲就能跑出同样的结果。
图像那一节讲目标检测,音频那一节讲预训练加分类与事件检测,视频那一节讲预处理加行为识别与动作分析。四种模态,四套流水线,读下来会有一种「我终于知道一条数据从原始文件到特征向量中间要过几道手」的踏实感。
四种模态里,视频给得最多,23 屏;音频最少,13 屏,差出将近一倍。这个分配是合理的:视频本来就是图像加音频加时序,前面三种的坑,它一个不漏地继承下来,还多一层「帧与帧之间怎么取」。2.4.1 视频预处理 16 屏、2.4.2 行为识别与动作分析 6 屏,两节撑起了 23 屏。而音频是 2.3.1 预处理 8 屏、2.3.2 分类与事件检测 4 屏,四节里最薄的组合。
这个薄有代价。音频在多模态里从来不是配角——直播高光时刻靠它判断主播的情绪爆发,医疗问诊靠它抓语速和停顿,工业质检靠它听异响。全书第 11 章真要解决「哪一段是高潮」,靠的正是 11.5「音频情感分析」那 5 屏。可它的底层方法在第 2 章只给了 13 屏,中间这段落差,读者得自己补。
但这种踏实感的代价是:80 屏里,几乎没有一句判断。它不会告诉你,什么场景下该用词袋、什么场景下该上 BERT;不会告诉你,音频事件检测在噪声环境下会崩成什么样;不会告诉你,行为识别这套方法在真实监控视频里的准确率是多少。它把「怎么做」写得很全,把「什么时候不该这么做」留空了。
这是教材的通病,也是一本教材能被当成教材用的原因。问题只在于,读者如果冲着「AGI 时代的方法论」来,会觉得这 80 屏是在补本科的课。
四、融合章讲的其实是 CNN 复习课
第 3 章「多模态数据融合」41 屏,目录排得很漂亮:特征级融合、决策级融合、模型级融合、混合级融合,这是经典的四层分法;后面再跟三节「进阶」:基于深度学习的特征自适应融合、基于跨模态语义对齐的一致性增强融合、基于图的图像关系推理融合。光看目录,这一章是全书的理论核心。
翻开 3.3.1,我读到的是这个:图像模态通常构建卷积神经网络,卷积层通过卷积核在图像上滑动提取边缘、纹理等局部特征,池化层对特征图下采样、降低维度;文本模态常用循环神经网络及其变体 LSTM,通过隐藏层状态的传递捕捉上下文信息,LSTM 进一步解决了长序列的梯度消失问题。
这一段讲的是 CNN 和 LSTM 是什么,不是「自适应融合」怎么实现。真正属于融合的那部分——两个模态的特征在哪一层拼接、用什么损失函数约束对齐、注意力怎么在模态之间分配权重——一个字没有。
更值得说的是,这本书里唯一把「跨模态对齐」讲清楚的地方,不在第 3 章,在第 12 章。12.2 节讲多模态大模型的训练,提到两个核心步骤:对齐特征的预训练和端到端的微调;并以 CLIP 为例,说它用预训练的模态编码器把图像转换成一串数字,也就是特征向量,再让这些图像特征向量与文本特征向量关联,使图像和文本在一个新的、共同的特征空间内相互映射。
这段话是对的,也是这一章最有价值的一段。但它出现在第 426 页,距离该讲它的第 133 页,隔了 293 屏。一本讲多模态的书,把「模态怎么对齐」这个核心问题,放在了最后一章的案例里顺带说。
图 12-1 倒是一张好书里的图。它画的是多模态大模型的本质:文本进大语言模型,视觉那一路标注着「支持图像信息输入,不支持视频,但支持多张图像的序列输入」,音频那一路也是接进来的。这个标注很细,说的是当下主流模型的一个真实限制——它们看的是「一堆图」,不是「一段视频」。能把这句话写进图里,说明作者知道边界在哪。
五、「巅峰对垒」用了三屏,一个分数都没给
第 8 章 8.4 节的标题是「GPT 与 DeepSeek:多模态数据分析领域的交锋」,三小节排下来:8.4.1 GPT——多模态先驱,当下实力究竟几何;8.4.2 DeepSeek——新晋黑马,突破重围有何独特优势;8.4.3 巅峰对垒——GPT 与 DeepSeek 多模态数据分析比拼。
看到「比拼」两个字,我以为会有一张表:几个任务、各自的准确率、谁赢几项。翻到 8.4.3,三屏正文,结论是这样的:GPT 的训练数据来源广泛,覆盖全球多种语言,但整体更偏英语环境,中文场景下可能出现文化适配性不足,比如对有深厚中国文化内涵的成语、俗语,可能无法准确理解背后的文化意义,翻译或解释时出现偏差;DeepSeek 由中国本土团队研发,训练中涉及大量中文语料,对中文成语、文化背景及行业术语有更强的适配性,回答中文用户问题时能给出贴合本土习惯的响应。
然后,这一节就结束了。第 8 章直接进小结。
没有任务集,没有评测指标,没有一个数字。「比拼」的三屏,比的是语料构成,不是能力。这就像两家饭馆评比,不试菜,只比谁的进货单更长。
我不怀疑作者的结论方向是对的——中文语料多的模型在中文成语上确实更稳。但「对的结论」和「有证据的结论」是两件事。全书最该出现一张 benchmark 表的地方,恰好是全书最空的地方。而这一节只有三屏,也说明作者自己知道这里没东西可写。
六、四个案例章,没有一个效果指标
第 9 到 12 章是四个实战案例:肺结节识别、疾病早筛、直播高光时刻、短视频灵感。四章加起来 88 屏。我逐页看下来,最直接的感受是:工程细节很足,效果数字一个没有。
第 9 章最典型。29 屏里,9.3.1「CT 影像数据预处理」独占 13 屏,是全书最细的一段:用 SimpleITK 读 mhd 和 dicom 文件,GetOrigin() 取原点、GetSpacing() 取体素间距,因为每个图像不同、目标检测区域的位置与原点距离不同;把 512×512 的图像按步长 4 裁剪,得到 128×128 的图;再按步长 16 降到 29×29 的候选样本,最后让模型对 29×29 个候选逐一预测。
这套流程是真的。任何一个做过医学影像的人都知道,决定模型上限的不是网络结构,是这一步重采样和候选框怎么切。作者愿意在这里花 13 屏贴代码,说明他是干过这个活的。
9.3.2 用 TensorFlow 搭 CNN,7 屏;9.3.3 用模型识别疑似病灶,6 屏。翻到最后一页,是一张 3D 散点图,图注写着「疑似肺结节区域的 3D 图」,X、Y、Z 三个轴上是不同颜色的点。
然后就是 9.4 小结,一句「建立了一套肺结节辅助诊断筛查机制和算法」。
准确率多少?召回率多少?假阳性率多少?在一个 29×29 的候选网格上,模型报出来的是几百个疑似,还是几个?这些一个都没写。医学影像模型的全部价值就在这几个数上——一个召回 95%、假阳性一堆的模型,在临床上等于没用,因为医生不会去看几千个候选框。作者把预处理讲到体素间距,却把结果留在了「建立了一套」这五个字里。
第 11 章讲直播高光时刻,四路信号协同:视觉内容识别、弹幕评论解析、音频情感分析,最后 11.6 节「协同确定直播高光时刻」。思路是对的——单看画面会漏掉「主播说了句狠话」这种时刻,单看弹幕会误判刷屏。但同样,融合之后准不准、比单模态好多少,没有。
第 12 章有一处写得挺真。12.2 讲局限时列了三条:一是数据依赖,训练数据的质量和多样性直接影响性能,如果某类短视频内容较少,模型分析时可能出现偏差,对小众领域或新兴类型的视频,可能无法准确识别关键元素和主题;二是复杂语义,模型面对隐含、暗示或特定文化背景的知识时可能误解,比如含特定地域文化「梗」或网络流行「暗语」的短视频,可能给出不准确的解读;三是算力,实际应用中算力有限的平台可能无法顺畅运行高性能多模态大模型,处理大量视频时响应时间会变长,影响实时性。
这三条都是真话,而且第二条说得比大多数书都准——模型听不懂「梗」,不是因为笨,是因为梗的意思不在字面上,在共同经历里。这跟第 1 章讲的「文字说没事、脸在绷着」是同一类问题,只是升了一层。差的地方在于,这三条全都停在定性:小众领域是多少样本算小众?响应时间多长算长?没有数。
这四个案例的价值,是让你知道一个多模态项目从数据到模型中间有哪些坑;它们的缺口,是让你不知道走完这条路之后,东西能不能用。
七、全书最硬的一节,在第 10 章
如果只让我推荐一节的篇幅,我推荐 10.3「疾病早筛实际业务过程和价值预估」。19 屏的一章里,这五屏是全书写得最像「真事」的地方。
它假设一个具体场景:公司打算组织一个 2 万人的疾病早筛项目。流程是这样——先从数据库里按以往经验预估目标人群数量,再给目标人群发短信和问卷;用 pickle 库调用 OneHotEncoder 把变量编码成「时间型+分类型」的形式,用 XGBoost 预测患病可能性,最后按患病可能性从大到小给人群排队,业务方直接按预期取前若干名。
这里有三处细节,是只有真做过的人才会写出来的。
第一处:目标人群不是越多越好。书里说得很直白——疾病早筛对老百姓是福利,由保险公司出钱让大家免费检查,这样部分人就有动机主动参与,使一些真正需要帮助的患者失去机会。所以算法工程师要做的,不是把池子做大,是按业务时间节点预测「数据库里的人群得肺癌的可能性」,然后排序取前 N。这句「部分人有动机主动参与,使真正需要帮助的人失去机会」,是全书唯一一处谈到了激励错配的地方。
第二处:问卷要设「检验题」。书里说,回收问卷后,由于部分人可能瞒报身体状况,机制上需要设置一些检验问题来辨别问卷答案的真实性,比如根据数据库里的记录设计一些互相关联的问题。这是把「数据质量」落到了「人会撒谎」这个现实上。
第三处:落地要靠组织,不靠模型。书里写,早筛前期需要一定的宣传与组织工作,特别需要政府或社区机构帮助,单纯靠保险公司是很难推动的;在有相关机构帮助的情况下,人们更容易相信这是福利活动而不是商业活动,从而提升响应率。
这三处加起来,是一套完整的业务逻辑:模型只负责排序,剩下的事全是组织和人性。这段内容在别的书里通常被写成一句「要注意数据质量与业务配合」,这里给了具体做法。19 屏的一章,价值不输前面 80 屏。
八、它的短板
第一,书名与内容错位。副标题是「AGI 时代的数据分析方法与实践」,但 AGI 的载体——大模型——只占 39 屏(8.8%),比统计学 49 屏少。全书没有一节讲多模态 Agent 怎么做、没有讲 RAG 里图文混排怎么检索、没有讲长视频理解的时间定位问题。第 8 章讲大模型架构时,给的是 AI Embedded、AI Copilot、AI Agent 三种模式加一张示意图,属于框架介绍,不是方法。
第二,融合这一核心命题,被稀释了。四层融合的分法是对的,但落到实现,只讲了 CNN 和 LSTM 是什么。跨模态对齐的真东西——对比学习、交叉注意力、统一特征空间怎么训——被推迟到第 12 章的案例里,以两段话的篇幅带过。一本讲多模态的书,最重要的那一章,是全书写得最像复习资料的一章。
第三,案例章缺结果指标,这是硬伤。四个案例,零个准确率、零个召回率、零个基线对比。第 9 章的 3D 散点图甚至没有图注说明点的颜色代表什么。技术书可以不吹效果,但不能不报效果——不报,读者就无法判断这套方法值不值得抄。
第四,有几处编号与结构上的窟窿。第 8 章的小节号从 8.3.1 直接跳到 8.3.3,中间没有 8.3.2;我抓到的电子版在这里也是断的,340 屏之后直接是 343 屏,中间两屏是空的。第 9 章、第 11 章都没有小结,第 10 章、第 12 章有。这种不齐,在一本 12 章的书里显得随意。
第五,数据来源基本不标。全书正文没有参考文献,没有论文引用,也没有数据集出处。第 7 章那张「某 App 印度站点一天的用户搜索数据」可视化,图里能认出 WhatsApp、Facebook Messenger、bangbang、flipkart 这些词,说明数据是真的,但它是哪个 App、多大样本、哪一天,一个字没交代。第 12 章讲多模态大模型时提到 GPT-4、Gemini、LLaVA,也全是裸名,没有版本号、没有参数量、没有对应的技术报告。
第六,推荐语里有个用词习惯值得记一笔。推荐语中有一条写「多模态数据是通向 AGI 和 ASI 的关键」。ASI(超级智能)和 AGI 不是一个东西,把两者并列,是这两年出版界的一种惯性修辞——上一本我读的《生成:AI 生产力重构营销新范式》,正文里也把 AGI 写成了 ASI。这不是这本书独有的问题,但它提醒你:看这类书,封面和推荐语里的词,要先打个折。
九、一句话
这本书的价值不在封面写的「AGI 时代」,在它老老实实告诉你:多模态的门槛不在模型,在于你能不能把 30fps 的画面和 44100Hz 的声音对上,能不能把 512×512 的 CT 切成 29×29 个候选框,能不能想到问卷里要设一道检验题防止人撒谎。前面 107 屏是补课,中间 208 屏是教材,最后 127 屏才是它真正想说的话——而它最该说的那几句效果数字,一句也没说。
阅读记录:《多模态数据分析:AGI 时代的数据分析方法与实践》,巴川等著,微信读书 442 屏,12 章 114 节,2026-11-17 逐页读完(end=last_page,347 秒)。文中屏数为逐页统计的实际值:第 1 至 12 章依次 13/80/41/49/39/37/42/39/29/19/20/20 屏,合计 428 屏,加文前 14 屏,共 442 屏,与总数核对一致。引用的代码与数字均取自截图原文,未作改写。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: