32B 多模态模型做内部数据脱敏,够用吗?
2026-09-16
最近在做一件很具体的事:给内部的一批文件、数据表和音视频做脱敏,然后喂给大模型用。选型时最常被问到的一句话是——「我们本地部署一个 32B 的多模态模型,够不够?」
这个问题的答案不是「够」或「不够」,而是你让它承担哪一层责任。下面是我按这个口径做的完整评估,结论先给:32B 多模态模型是这类工作里性价比最高的「语义裁决层」,但它不是一个脱敏系统。把它当成唯一防线,是这类项目里最常见、也最昂贵的一个误判。
一、先把问题拆对:脱敏是五个动作,不是一个
脱敏不是「识别敏感信息」这一个动作,而是:
识别(召回)→ 定位(精确 span / 人脸框 / 时间轴)→ 变换(假名化 / 遮蔽 / 泛化)→ 验证(重标识风险)→ 审计(可追溯)
32B 多模态真正强的是第一个动作的一部分,第三个动作它甚至不应该参与。先把这条线划清楚,后面的判定才有依据。
二、四组硬数据
下面的判定不是凭经验画的,是四组可查的实测数据撑起来的。
1. 同一个模型换个数据集,F1 直接腰斩
OpenAI 开源的 Privacy Filter(1.5B,MoE 架构每次只激活约 5000 万参数)在 PII-Masking-300k 上 token 级 F1 达到 0.96、召回 0.98,看起来完全够用。但换到 CredData 的密钥 / 凭证场景,span 级 F1 掉到 0.617、精确率只剩 0.747;再换到严格的多语种基准,只剩下 0.171。
结论很直接:任何拿单一数据集 F1 向你证明「够用」的方案,都值得打一个问号。
2. 顶级闭源模型在同一把严格尺子下也只有六成
REDACT-PII 基准包含 1000 条锁定样本、25 个语种、24,199 个标注实体、覆盖 51 类敏感实体。在这个基准上按严格的 span 边界对齐计算精确 F1:
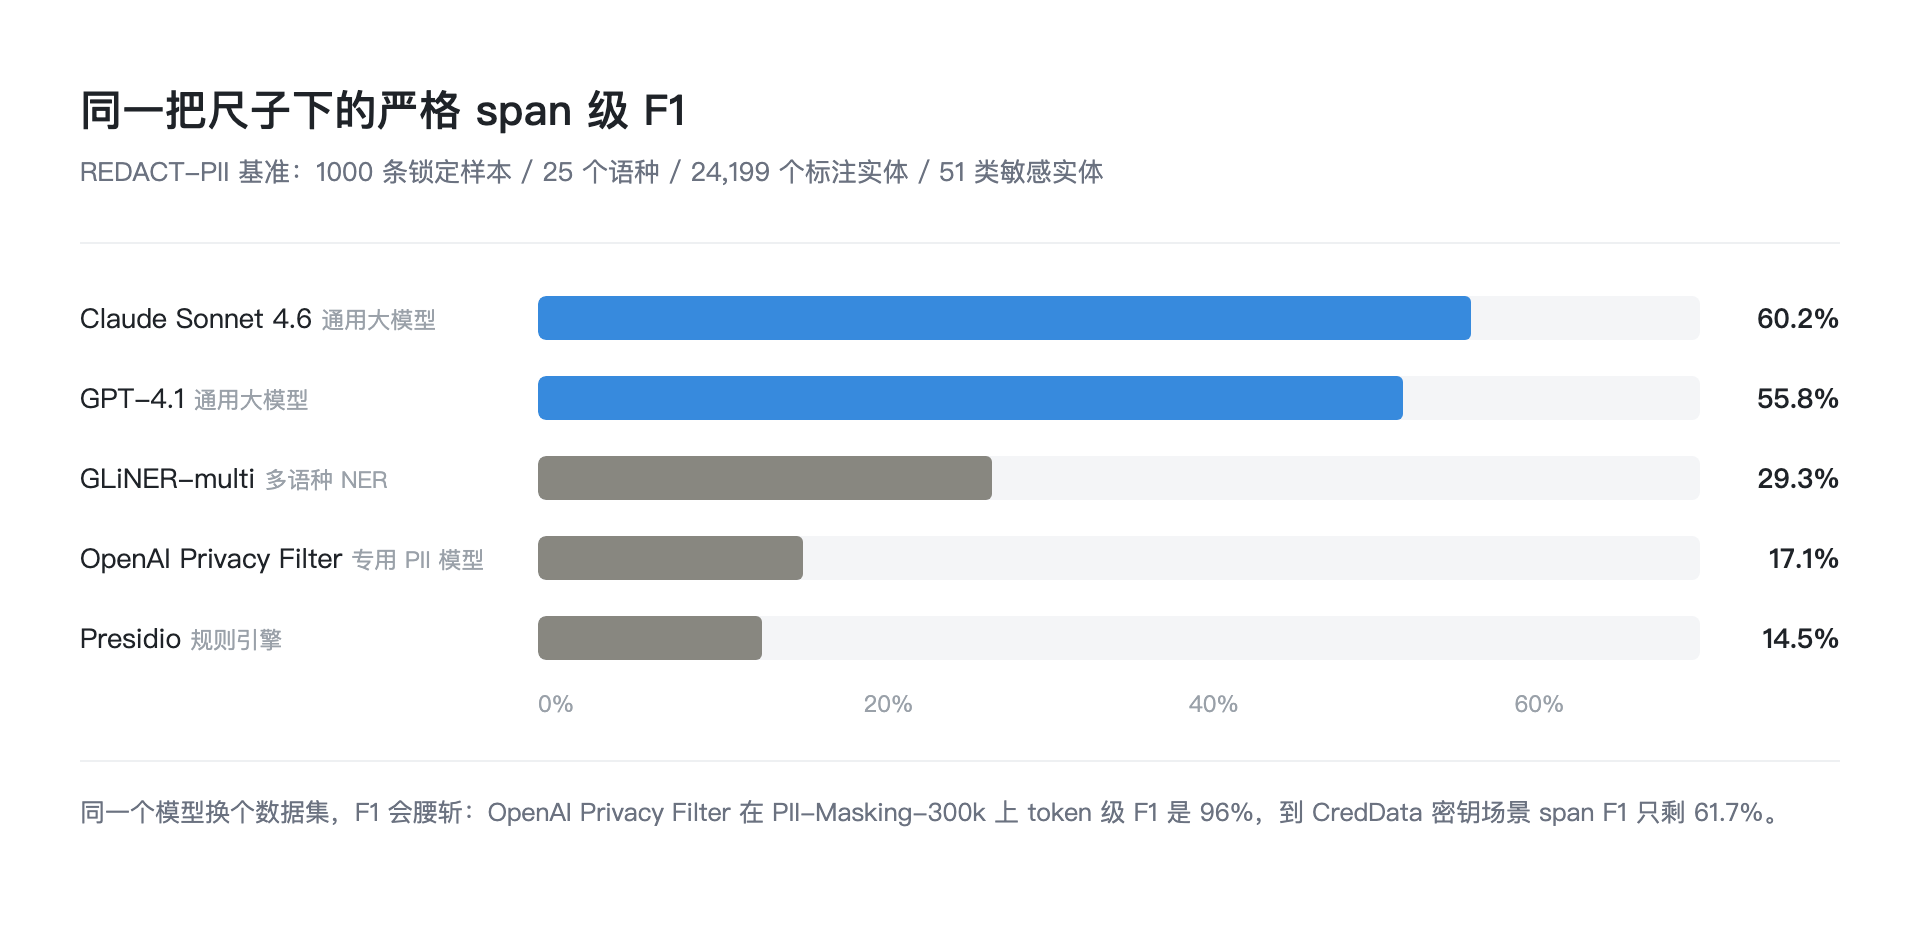
Claude Sonnet 4.6 是 60.2%,GPT-4.1 是 55.8%,专用多语种 NER 模型 GLiNER-multi 只有 29.3%,OpenAI Privacy Filter 17.1%,而规则引擎 Presidio 是 14.5%。
还有一组容易被忽略的数字:GPT-4.1 在这个基准上的 partial micro-F1 是 59.7%,而 exact micro-F1 只有 55.8%。这 4 个百分点的差距,本质是「大致圈对了位置,但边界不准」。对摘要任务无所谓,对脱敏是致命的——少删一个字符,一个人的姓名或证件号就完整留在原文里。
3. 32B 视觉语言模型的短板是「定位」,而脱敏恰恰要精确框
一篇针对细粒度空间定位的对照研究(CrossProjection,覆盖 23 套真实图纸、每套 1954 个判定条件)给出了很说明问题的数字:Qwen3-VL-32B-Instruct 在类别判断题上能拿到 62.2%(GPT-5.5 为 82.4%),但一旦要求自由形式的点 / 区域定位,精度 PCK@.05 只有 8%–10%,线段端点定位只有 4%;同样条件下 GPT 系为 54%–76% 和 22%。
论文的结论值得抄在本子上:「封闭式选项选对了,并不意味着模型具备可靠的、显式的定位能力。」
翻译到脱敏语境就是——它能告诉你「这张图里有身份证」,但不能可靠地告诉你「身份证在哪一个 120×80 像素的框里」。图像脱敏请交给专用 CV(人脸检测、车牌检测、版面分析),不要交给视觉语言模型。
4. 参数量的边际收益极低,瓶颈在标签体系而不是规模
前面那个 1.5B 的专用 PII 模型,在它自己的领域内能打到 0.96,而参数量大得多的通用模型在同一任务上反而更差。这说明脱敏的瓶颈是标签体系与训练数据,不是参数量。
同理,Qwen3-VL-32B 的 OCR 指标(OCRBench 85.5、DocVQA 96.1)说明印刷版式文档没问题,但中文困难场景(OCRBench v2 中文 62.1)已经不够看——手写、低质扫描、盖章遮挡、表格线交叉,全落在那 38% 里。
三、音视频是全链条最弱的一环
开源中文 ASR 的普通话字错误率 CER 在 2.89%(FireRedASR2-LLM)到 4.16%(Fun-ASR)之间,方言平均 CER 11.55%,上海话超过 24%。
对「听个大意」这够用。但脱敏要求的是人名、身份证号、手机号逐个字符正确——而数字串和专有名词恰恰是 ASR 错误率最高的地方。3% 的 CER 意味着每 100 个字就错 3 个字,落在证件号上就是灾难。
目前 30B 级别的开源全模态模型里(例如 Qwen3-Omni-30B),确实有能直接吃音频的,但它的视觉锐度和 ASR 精度都打不过各自的专用模型。而视频侧的小时级时间轴定位、跨帧去重、说话人分离、声纹、画内字幕并行处理,本来就不该由一个模型承担。
四、合规上有一条不能越的线
这是最容易被技术团队忽略、但法务会第一个问的点:模型输出的是「去标识化」,不是「匿名化」。
按 GB/T 35273、GB/T 37964-2019,以及金融行业的 JR/T 0223-2021,匿名化后的数据不再属于个人信息;而去标识化后的数据仍然属于个人信息,仍然需要合法处理基础。这意味着上了 AI 脱敏,并不能免除你在收集、存储、共享环节的义务。更麻烦的是,个人信息去标识化效果分级评估要求你量化重标识风险(准标识符组合能否唯一锁定个体),这个数字模型给不出来——它只会告诉你「哪些片段是敏感信息」。
最典型的漏洞形态是:直接标识符删干净了,准标识符组合仍然唯一。比如「某事业部唯一的女 CTO,2019 年入职,分管华东,本次差旅报销 4.2 万」——一个标识符都没有,人却指得死死的。这类风险只能靠分级评估加准标识符泛化(取整、分层编码、k-匿名)解决,不在模型的职责范围内。
所以:模型是技术措施,不是合规证据。合规证据来自资产盘点、分类分级、影响评估和审计记录。
五、部署现实:32B 扫不动存量资产
Qwen3-VL-32B 的量化档位大致是 Q4 需要 20–24GB 显存、FP16 需要 30–42GB;RTX 3090 上大约 8–10 tokens/s,A100 80GB 大约 19 tokens/s。
这意味着拿它去全量扫描 TB 级存量共享盘和多年音视频,在成本上不成立。可行做法只能是分层:小模型 / 规则做全量粗筛,32B 只对候选片段做精判,再叠加抽样人审。这也是为什么 32B 只应该做「歧义裁决」——不只是精度问题,也是吞吐问题。
六、可落地的架构
正确的形态不是「一个 32B 管全部」,而是四路互补加一个融合层:
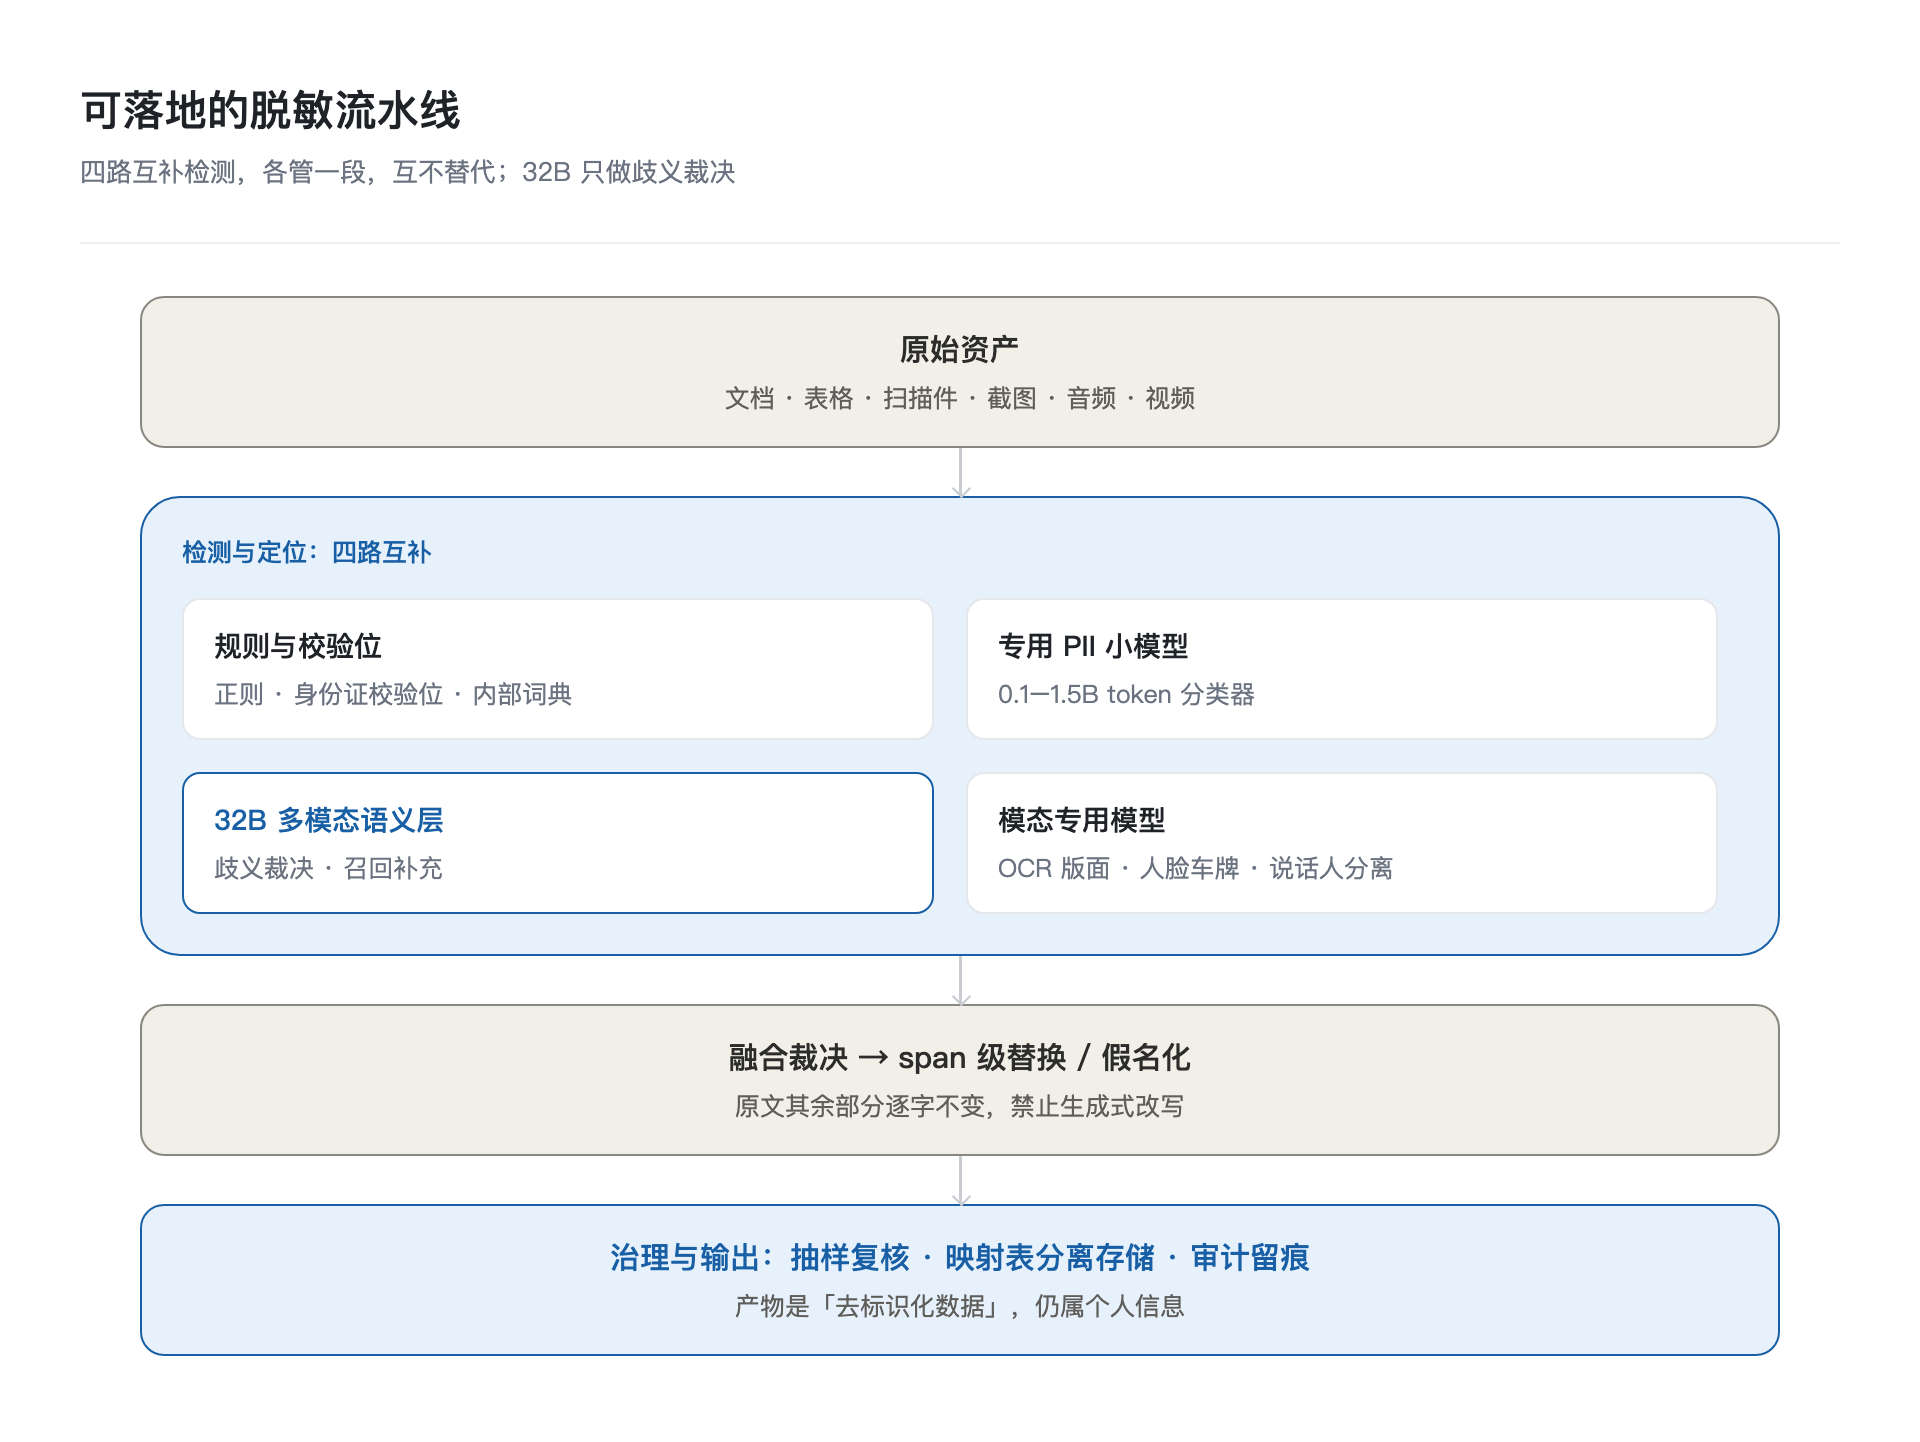
- 规则与校验位:正则、身份证校验位、内部词典。确定性最高,永远不产生幻觉。
- 专用 PII 小模型:0.1–1.5B 的 token 分类器。它才是删标识符的主力,不是那个 32B。
- 32B 多模态语义层:只做歧义裁决和召回补充。
- 模态专用模型:OCR 与版面分析、人脸车牌检测、说话人分离与 ASR。
四路结果融合后由确定性代码执行 span 级替换或假名化,最后进入治理层:抽样复核、映射表分离存储、审计留痕。
七、落地时必须避的六个坑
- 别让模型「生成脱敏后的文本」。生成式改写会篡改原文——数字幻觉、漏字、格式漂移。正确姿势是让模型只输出 span 列表,由确定性代码执行替换。token 分类架构在这里系统性优于序列生成架构。
- 别用同一个模型自检。用专用小模型或规则做二次校验,收益远大于同模型自我复核。
- 别忽略跨块一致性。长文档分块处理会出现「第 3 页的名字删了,第 40 页还留着」。
- 别只看整体 F1。必须按泄露形态分层验收:明文、部分遮蔽(张*明)、谐音、全角、空格错位、拼音、图片形态。公开数据已证明,模型在这些变体上的召回会从 0.98 掉到 0.86 附近。
- 别指望模型认识「你的内部敏感」。通用模型对内部项目代号、客户名单、财务口径几乎零召回,必须靠内部词典与黑名单补齐。
- 别把假名映射表和脱敏数据放在一起。映射表分离存储加权限收紧,否则脱敏等于没做。
八、验收口径建议
不要用「整体准确率」验收。建议自建一套 200–500 条起步的对抗测试集(覆盖上面那七种泄露形态),指标定为 exact span F1 + 高敏类型召回 ≥ 99.9% + 误报率,并且明确接受不对称代价:漏检的代价比误报高两个数量级,所以阈值坚决向召回倾斜,多出来的误报交给人审或二次模型消化。每次换模型、改提示词,都跑同一套测试集做回归。
九、最终判断
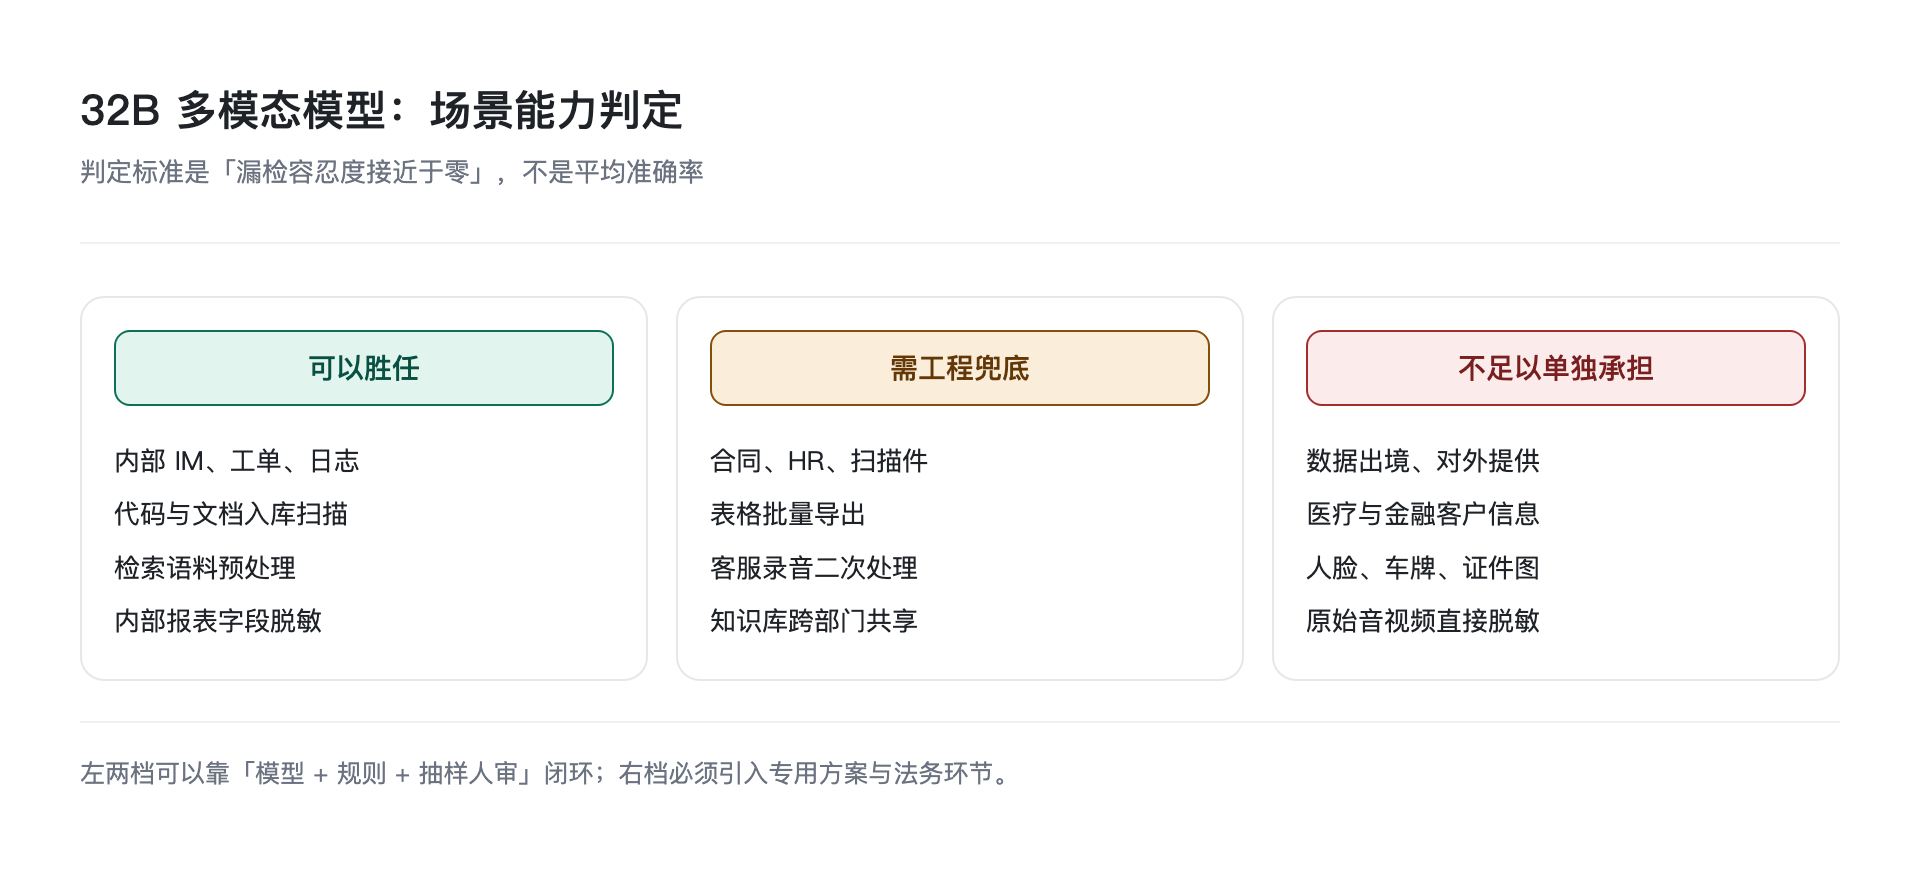
| 你的目的 | 32B 多模态够不够 |
|---|---|
| 内部二次处理,有人工 / 规则兜底 | 够,而且是当前性价比最高的语义层 |
| 对外提供、数据出境、跨主体共享 | 不够,只能当预筛,必须叠加法务与出境评估 |
| 医疗病历、金融客户信息 | 不够,且必须保留人工合规审核环节 |
| 图像 / 视频里的人脸、车牌、证件、屏摄 | 不够,换专用 CV,VL 模型的定位精度撑不住 |
| 原始音视频直接脱敏 | 不够,必须专用 ASR 加说话人分离加声纹加 CV |
如果用一句话概括这次评估:32B 多模态模型的能力上限,已经被三件事决定了——它认得出,但框不准;它不认识你的内部规则;它也无法自证合规。
把它放在融合层里当最聪明的那个裁判,配足规则、专用小模型和专用模态模型,这套组合在「内部使用」这个范围里完全够用,而且落地成本远低于想象。把它单独拉出来当脱敏系统——不够,而且是那种「测试集看着漂亮、真出事才发现漏检」的不够。
发表评论: