小米把 RL 训练开成了直播:看懂 mimo.xiaomi.com/rl 这个页面
2026-09-17
一句话说清
这是小米 MiMo 团队给 MiMo-V2.6 的强化学习(RL)训练开的一个「实时直播看板」。它不是模型发布页,也不是宣传页,而是把正在跑的训练任务的真实运行日志挂在公网上——花了多少钱、跑了多少 token、哪台机器挂了、某个数据集这轮通过了多少条,任何人都能随时刷新看。
页面的官方描述只有一句:Training metrics of the mimo-v2.6-pro and mimo-v2.6-flash reinforcement-learning runs, live from the trainer's logs.(两个 RL 训练任务的指标,直接从训练器的日志里流出来。)
背景:半年的沉默,一个问题
9 月 17 日,小米大模型负责人罗福莉(@_LuoFuli,前 DeepSeek)在 X 上发了一条推文。将近半年没有动静,她说团队把时间花在同一个问题上:
「强化学习到底还能扩多远?」
而这次给出的答案不是一篇论文,而是一场正在进行的直播。她说这轮训练主要在三个方向做了规模化:
- 算力:每步(step)约 20 亿 token,配置是 1568 条提示词 × 16 条 rollout,完全异步;
- 环境与 harness:多任务智能体 RL,一次训练里混跑多套 harness(评测/执行套件);
- 打分算力:智能体组内信用分配(in-group credit assignment),奖励信号来自测试用例 + 评分细则(rubric)。
她同时表示,这套工程实现的细节会在未来几周分批开源。也就是说,现在先让你看过程,代码稍后再给。
页面怎么看:三个标签页
整个看板只有三个页签:
| overview | 两个 run 的状态卡片(进度、花费、token、样本数、在线得分),数据集来源分布,以及实时滚动的采样队列日志 |
| metrics | 训练曲线面板,约 2000+ 项监控指标,可切换 step / 时间轴、线性 / 对数坐标、是否平滑 |
| about | 项目背景说明 |
曲线里橙色是 mimo-v2.6-pro,蓝色是 mimo-v2.6-flash,下文配图沿用这套配色。
直播间里此刻在播什么
我写这篇文章时(2026-09-17 上午,UTC+8)从页面接口取了一份实时快照。这个页面是活的,数字一直在动,下面这些只代表那一瞬间:
| 指标 | mimo-v2.6-pro | mimo-v2.6-flash |
|---|---|---|
| 参数量(总 / 激活) | 1T / 42B | 309B / 15B |
| 训练进度 | 已完成 12 步,第 13 步 rollout 中 | 已完成 17 步,第 18 步 rollout 中 |
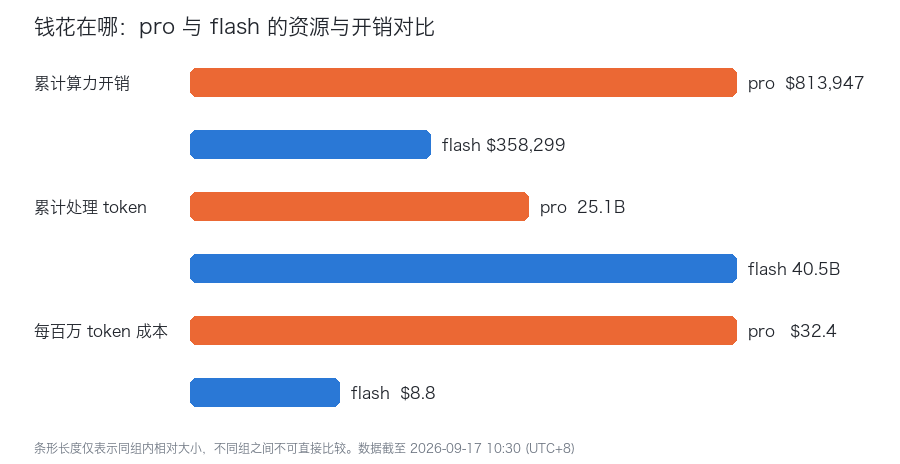
| 累计算力开销 | $813,947 | $358,299 |
| 单步 token | 2.33B | 2.74B |
| 累计 token | 25.1B | 40.5B |
| 累计训练样本 | 301,056 | 426,496 |
| 累计沙箱数 | 1,645,220 | 5,178,352 |
| 硬件故障重启次数 | 5 | 2 |
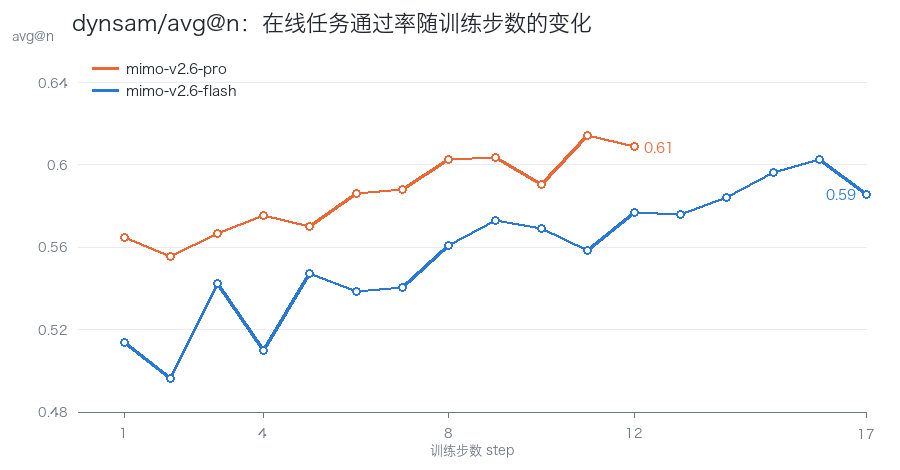
| dynsam/avg@n(相对第 1 步) | 0.609(+0.044) | 0.586(+0.072) |
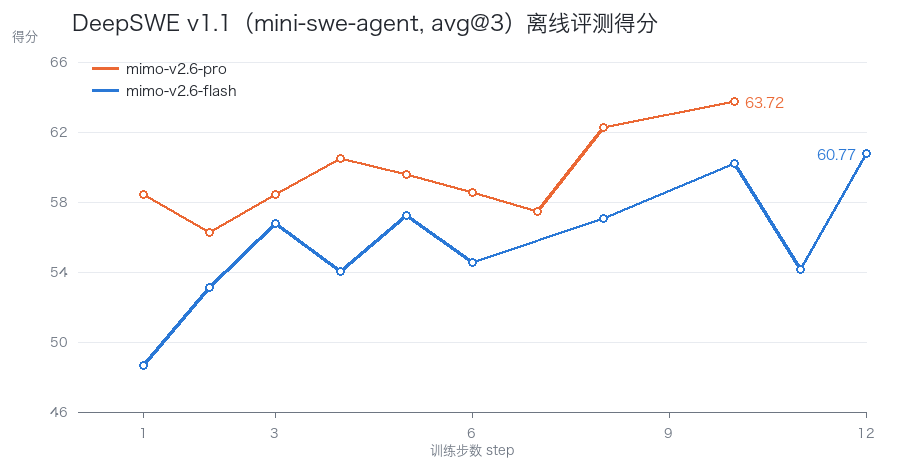
| DeepSWE v1.1(avg@3) | 63.72(第 10 步) | 60.77(第 12 步) |
| 折算每小时开销 | 约 $20,556 | 约 $10,278 |
两条曲线分别是两套模型每步的在线通过率和离线代码能力。注意 pro 的点更少——它的离线评测结果发布得比 flash 慢(页面通知里明确说会陆续补发)。
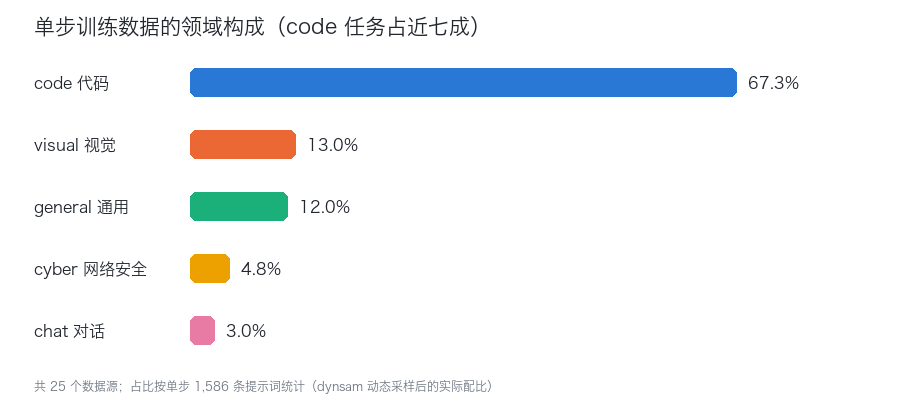
训练数据这边,单步 1586 条提示词里,代码任务占了将近七成:
花钱的效率上,两类模型的差距比绝对金额更值得看:
那些天书一样的指标,翻译成人话
metrics 页有两千多个指标名,其实核心就这些:
- dynsam/avg@n:dynamic sampler 的在线平均通过率,整轮训练最重要的一个数。系统按各数据集的实时通过率动态调整采样权重,数值越高说明模型越能做对;后面的「Δ vs step 1」是相对训练起点的净增益。
- rollouts:推演轨迹。Agent 和环境交互一次生成的完整序列,1568 × 16 就是每步 2.5 万条轨迹。
- harness:Agent 训练/评测套件,把环境执行、工具调用、结果打分整条链路封装起来。这次是「一次训练混跑多套 harness」,不再一个 run 只练一种任务。
- credit assignment:信用分配。一条几十步的轨迹最后只有一个奖励,哪一步该记功、哪一步该背锅,就是它在解决。
- rubric-based rewards:奖励不只来自测试用例跑没跑通,还有一份人工写的评分细则,用来给「写得对不对」这种事打软分。
- accepted / target:已接收样本 / 目标样本。你会看到 1344/1568 这种数,偶尔甚至超过 1568——那是超额采样,用来给异步流程留缓冲。
- partial / avg_staleness:全异步架构的专属指标。生成 rollout 的模型和正在更新的模型不是同一个版本,两者之间的时间差就是 staleness。它是这套架构换吞吐必须付的代价。
- actor / critic:PPO 的两个网络。actor 出策略,critic 估价值。配套的 pg_loss、entropy_loss 控制探索性和梯度,KL 则约束新旧策略别跑偏太远——防止训练崩掉。
真正稀罕的地方:不是发榜,是公开过程
大模型做 RL 训练,历来是各家最保密的部分。理由是现成的:算力成本敏感、方法还没定型、开源等于把作业给人抄。行业惯例是只开放结果——DeepSeek、Kimi、Qwen 基本都开源权重或发论文,但训练过程照样关着门。
小米这次反过来了:先公开过程,代码晚点再给。看板上甚至有一条系统通知,直白地写着 pro 的训练因为某个节点显存故障正在重启。换别家,这种事故是绝不会对外说的。
这种透明至少有三层价值:研究者第一次能实时看到 RL scaling 的真实动态,而不是事后看一条被修饰过的曲线;batch 级数据公开,等于把「训练到底扎不扎实」交给外面检验;再就是新鲜感本身——不少人说,光看着一个模型在训,就已经挺有意思了。
从这份快照里能读出什么
几点我觉得比数字本身更有意思:
- Flash 从 RL 里吃到的好处明显更多。dynsam 在线通过率从 0.514 涨到 0.586(+0.072),DeepSWE 从 48.67 涨到 60.77(+12.1 分);而 pro 分别是 +0.044 和 +5.3 分。起点越高,RL 能往上推的空间越窄——这个规律在这个规模上依然成立。
- Pro 的单位算力成本是 Flash 的约 3.7 倍。pro 花了 $813,947 处理 25.1B token(约 $32.4/百万 token),flash 花 $358,299 处理 40.5B token(约 $8.8/百万 token)。Flash 用不到一半的钱,处理了 1.6 倍的 token。Agent RL 的成本随模型规模上升得非常陡。
- 代码任务是绝对主力,但不是全部。67.3% 是 code,剩下的是视觉 13.0%、通用 12.0%、网络安全 4.8%、对话 3.0%。一共 25 个数据源——单看一片多域混合,而不是只练写代码。
- 全异步是这轮工程的主线。rollout 和参数更新完全解耦,换来的是硬件利用率,代价是新出现的 staleness 指标需要盯着。这是 2026 年 Agent RL 的主流选择,但配套的漂移管控才是难点。
- 这轮训练已经烧掉约 117 万美元(pro + flash 合计,截至本文快照)。按页面自己的口径,这还只是已经跑完的步数产生的实际开销,后面的路还长。
值不值得跟
值得,但别急着看榜单——这个页面上没有任何 benchmark 之外的性能结论,也没有发布日期和参数细节之外的承诺。真正决定这轮实验成色的,是团队说的那几周之后分批放出来的工程细节。
如果你在做 Agent 或者后训练,建议重点盯三件事:多套 harness 怎么在同一个 run 里混跑、rubric 打分的奖励怎么和测试用例组合、以及异步带来的 staleness 怎么控。这三块,恰恰是现在公开资料最少的地方。
数据来源:mimo.xiaomi.com/rl 公开接口实时快照,采集时间 2026-09-17 10:30(UTC+8);背景信息来自罗福莉 @_LuoFuli 的公开发言。页面是活的,数字随时在变,文中数值仅代表采集时刻。
发表评论: